Stand 22. November 2026. Fortsetzung zu Zuse — mein Heim-AI-Server.
Zuse ist mein Heimserver: eine HP Z840 von 2014 mit 128 GB RAM und drei gebrauchten RTX 3090, jede auf 250 W gedeckelt. Am 21. November habe ich Inkling 2 Mini, ein Modell für Hopper und Blackwell, mit 13 Patches auf einer einzelnen 3090 zum Laufen gebracht. Dieser Artikel erzählt, was danach kam. In der Nacht zum 22. November habe ich den ganzen LLM-Stack umgebaut. Seitdem läuft auf allen drei Karten nur noch Inkling, davor sitzt ein eigener Router.
Kurz gesagt:
- Breite: sechs Plätze à 128K statt vier, verteilt auf drei unabhängige Karten.
- Tempo: 74 Token/s pro Karte, mit spekulativem Dekodieren bei Code 101 bis 141.
- Qualität: in der schweren Coding-Aufgabe auf dem Niveau von Flash-Next, klar vor dem Qwen3.8-27B.
- RAM: Unter Volllast wird nichts mehr ausgelagert.
- Router: verteilt die Anfragen, hält Gespräche auf ihrer Karte und schützt das Kontextfenster.
Vorher
Seit dem 14. November lief diese Aufteilung:
| Karten | Plätze | Tempo | |
|---|---|---|---|
| Flash-Next (2 Bit, Strata-Engine) | GPU0 + GPU1 | 4 à 100K | allein kurz 99 t/s, bei 4 × 100K je 19–21 t/s |
| Qwen3.8-27B (4 Bit, vLLM) | GPU2 | 64K | 38,5 t/s |
Flash-Next war das bessere Coding-Modell (siehe Messlabor). Es hatte aber drei Haken.
- Nur vier Plätze. Mehr gab die Engine auf zwei Karten nicht her. Bei mehreren Agenten gleichzeitig wurde es eng.
- RAM. Strata hält Teile des Modells und den Gesprächs-Cache im Arbeitsspeicher. Vor dem Umbau lagen 16 GB im Swap, und zwar dauerhaft.
- Layer-Split. Das Modell war auf zwei Karten aufgeteilt, Schichten 0–27 auf GPU0 und 28–47 auf GPU1. Pro Rechenschritt arbeitet dann nur eine der beiden Karten, die andere wartet. Mehr Parallelität bringt so kaum mehr Durchsatz.
Das 27B auf der dritten Karte war schnell zur Hand, aber in der schweren Aufgabe deutlich schwächer (siehe unten).
Der Umbau
Inkling lief seit dem 21. November nachmittags auf GPU2 anstelle des 27B. Die ersten Messungen waren gut genug für die Frage: Warum nicht auf allen drei Karten?
- Flash-Next und das 27B sind abgeschaltet und geparkt, die Gewichte liegen noch da.
- Drei vLLM-Instanzen, je eine pro Karte, alle mit demselben gepatchten Image.
- Jede Instanz hat 2 Plätze à 128K, insgesamt also 6.
- Alle Clients (Coding-Agenten, Chat-Oberfläche, Assistenten) sprechen nur noch den Router an.
Ein Rückweg ist da. Ein Skript startet Flash-Next wieder, die alten Compose-Dateien liegen geparkt daneben.
Warum drei einzelne Instanzen statt Tensor-Parallel über alle Karten? Die Karten haben kein PCIe-P2P (der Chipsatz C612 kann das nicht), und Inkling passt mit 4-Bit-Experten auf eine einzelne 24-GB-Karte. Drei unabhängige Instanzen haben keinen Kommunikationsaufwand untereinander, und fällt eine aus, laufen die anderen weiter.
Baustein 1: ein eigenes vLLM für Ampere
Die 13 Patches machen das Modell auf einer 3090 lauffähig: FP8-KV-Cache in Software, ein MoE-Kernel in PyTorch, Triton-Funktionen abgeschaltet. Neu dazugekommen ist DSpark.
DSpark: spekulatives Dekodieren
Im Checkpoint steckt ein kleiner Draft-Kopf (0,64 GB). Er rät 7 Token im Voraus, das große Modell prüft sie in einem
Durchgang. Stimmen sie, spart das Rechenschritte. Auf Ampere startete das erst gar nicht. Der erste Draft-Schritt
brach mit no kernel image is available ab.
Die Ursache war tiefer als erwartet. Das vLLM-Image ist nur für Compute Capability ab 9.0 gebaut, und seine kompilierten Kernels haben überhaupt keine Variante für die 3090 (sm_86). Zwei Bausteine im Draft-Pfad hingen daran:
- RMSNorm nutzt flashinfer, und auch das
rms_normvon vLLM hat kein sm_86. Ersetzt durch eine PyTorch-Fassung mit fp32-Rechnung. - Draft-KV schreiben lief über
reshape_and_cache_flash, ebenfalls ohne sm_86. Ersetzt durch einen eigenen, kleinen Triton-Kernel. Er überspringt Füll-Slots, schreibt FP8 mit derselben Software-Umrechnung wie die übrigen Patches und kommt ohne Synchronisation mit der CPU aus, damit CUDA-Graphs weiter funktionieren.
Eine Lehre aus der Fehlersuche: Der Fehler „no kernel image“ meldet sich oft erst beim nächsten Kernel-Start, nicht bei dem, der eigentlich fehlt. Wer einzelne Operationen prüft, muss danach synchronisieren und noch einen kleinen PyTorch-Kernel starten. Sonst sieht die schuldige Operation unschuldig aus. Genau so hat mich die RMSNorm-Probe zuerst getäuscht.
Alle Patches liegen offen auf GitHub: MKRWW/inkling2-ampere.
Tempo pro Karte
Gemessen am 22. November auf einer Karte, 250 W, 700 Ausgabe-Token, Thinking aus:
| ohne DSpark | mit DSpark | |
|---|---|---|
| Code, 1 Anfrage | 74 t/s | 135 t/s isoliert, 101–141 t/s im Betrieb |
| Code, 2 parallel | je 61 t/s | je 100–114 t/s |
| Fließtext, 1 Anfrage | 74 t/s | 72 t/s isoliert, 45–73 t/s im Betrieb |
| Fließtext, 2 parallel | je 61 t/s | je 57–58 t/s |
| KV-Cache je Karte | 246.531 Token | 163.892 Token |
„Isoliert“ heißt: allein auf der Karte. „Im Betrieb“ heißt: gemessen, während auf den anderen Instanzen echte Last lief.
- Code profitiert stark. Code ist gut vorhersagbar, der Draft trifft oft. Im Schnitt werden etwa 19 % der geratenen Token übernommen. Weil jeder Durchgang 7 Vorschläge prüft, reicht das für +83 % bei Code.
- Fließtext profitiert nicht. Isoliert bleibt er gleich, unter Last wird er eher langsamer als ohne DSpark.
- DSpark kostet KV-Cache. Pro Karte bleiben 163.892 Token. Zwei Gespräche mit vollen 128K passen damit nicht mehr gleichzeitig auf eine Karte, sondern nur das 1,25-Fache von einem. In der Praxis sind selten beide Plätze voll lang. Wenn doch, wartet einer.
Zum Vergleich: Flash-Next schaffte allein bei kurzen Prompts 99 t/s, bei vier parallelen Gesprächen mit 100K je 19–21 t/s. Die Bedingungen sind aber nicht gleich: damals 100K Kontext, hier kurze Prompts mit 700 Token. Einen Langkontext-Vergleich unter gleichen Bedingungen habe ich für Inkling mit DSpark noch nicht gemessen.
Das Power-Limit bleibt bei 250 W
Unter Last hängen die Karten am Limit und takten mit etwa 1.700 statt 1.950 MHz. Mehr Watt würden laut früherer Messung rund 16 % mehr Tempo bringen. Ich lasse das trotzdem. Die Karten sind von 2020 und gebraucht gekauft. Tempo hole ich lieber über Software, und DSpark war genau so ein Hebel.
Baustein 2: der Router
Der Router ist ein kleiner Python-Dienst vor den Modellen. Er existierte schon vorher, damals mit zwei Zielen: „solo“ für Flash-Next und „parallel“ für das 27B.
Pool statt zwei Ziele
- Neue Gespräche gehen an die Instanz mit den wenigsten laufenden Anfragen.
- Folgeturns bleiben an ihrer Instanz. Dort liegt der Prefix-Cache, also der schon berechnete Anfang des Verlaufs. Wechselt ein Gespräch die Karte, muss der ganze Verlauf neu eingelesen werden. Bei 60K Token dauert das rund 40 s. Test: 4 von 4 Folgeturns blieben auf ihrer Instanz.
- Ist eine Instanz nicht erreichbar, versucht er einmal eine andere. Das ist wichtig, denn GPU2 lässt sich auf Bildgenerierung oder Musik umschalten. Dann verteilt der Router eben nur auf zwei Karten.
Die Sonderregeln für Flash-Next sind ohne Funktion, solange es nur ein Modell gibt. Ein leerer Eintrag schaltet „solo“ ab, alles geht an den Pool. Dabei fiel eine Altlast auf: Das Größenlimit stand noch auf 65.536 Token, ein Rest aus der 27B-Zeit. Alles über 60K bekam einen Fehler. Jetzt steht es auf 131.072.
Was der Router mit dem Kontextfenster macht
Das eigentlich Interessante am Router ist, wie er mit dem Kontextfenster umgeht. Jedes Modell hat 131.072 Token für Prompt und Antwort zusammen. Coding-Agenten wissen das nur ungefähr und verlangen trotzdem pauschal 32.000 Token Ausgabe. Der Router sorgt in fünf Schritten dafür, dass trotzdem nichts beim Modell scheitert.
- Ehrlich melden, mit Reserve. Unter
/v1/modelsmeldet der Router für die Modelleautoundauto-think128.000 Token, nicht die vollen 131.072. Daran richten Clients aus, wann sie zusammenfassen. Die gut 3.000 Token Differenz sind Puffer für Systemprompt und Schätzfehler. - Schätzen ohne Tokenizer. Der Router zählt Zeichen der Nachrichten und Werkzeug-Definitionen und teilt durch 3. Bilder zählen pauschal 2.048 Token. Das ist absichtlich grob und eher zu hoch. Dafür braucht der Router keinen Tokenizer und bleibt modellunabhängig.
- Kürzen statt ablehnen. Passt der Prompt, aber nicht die verlangte Ausgabe, setzt der Router
max_tokensauf den Platz, der noch frei ist. Das Modell lehnt die Anfrage dann nicht mit einem Fehler ab, es antwortet eben kürzer. Der HeaderX-Router-Limit: clamp 32000->4892zeigt, was passiert ist. - Früh nein sagen. Bleiben neben dem Prompt keine 4.096 Token für die Antwort, ist die Anfrage zu groß. Dann antwortet der Router sofort mit 413 und belegt keinen Platz auf einer Karte.
- Den Verlauf schlanker machen. Das Pruning, siehe nächster Abschnitt. Es sorgt dafür, dass lange Agenten-Läufe gar nicht erst an die Grenzen aus 3. und 4. kommen.
Dazu kommt die Bindung an die Instanz. Sie hält den Prefix-Cache warm, damit ein langer Verlauf nicht bei jedem Turn neu eingelesen wird.
Schritt 3 hat übrigens eine Kehrseite, und genau die steckte hinter den Abbrüchen weiter unten.
Kontext-Pruning
Coding-Agenten schicken bei jeder Anfrage den ganzen Verlauf mit, also auch Dateien, die vor einer halben Stunde gelesen wurden, und Build-Logs. Der Router kürzt das, bevor es beim Modell ankommt:
- Doppelte Aufrufe: Liest der Agent dieselbe Datei zweimal, wird die ältere Ausgabe zu einem Platzhalter.
- Alte große Ausgaben: Überschreitet die Anfrage geschätzt 75K Token, werden alte große Werkzeug-Ausgaben vom ältesten an gekürzt, bis die Anfrage unter 35K liegt. Stehen bleiben die ersten 300 Zeichen, die jüngsten 6 Ausgaben bleiben vollständig.
Der Trick dabei betrifft den Prefix-Cache. Das Modell rechnet ab der ersten geänderten Stelle neu. Würde die Kürzungsgrenze bei jeder Anfrage ein Stück wandern, wäre jede Anfrage ein Cache-Fehlschuss. Deshalb merkt sich der Router die Grenze je Gespräch und verschiebt sie nur in Stufen. Dazwischen bleibt der gekürzte Anfang Byte für Byte gleich.
Gemessen:
- Eine Anfrage mit 251.000 Zeichen Verlauf kam beim Modell mit 54.731 Token an. Gekürzt wurden 3 doppelte und 9 alte Ausgaben.
- Dieselbe Anfrage noch einmal: 2,5 statt 40 Sekunden, weil der Cache traf.
Die erste Fassung hatte die Schwellen 60K und 40K. Im ersten echten langen Lauf wanderte die Grenze damit fast bei jeder Anfrage. Der Grund: Die Antworten des Modells selbst wurden nie gekürzt und wuchsen weiter. Jetzt laufen 75K und 35K. Damit springt die Grenze seltener, aber dafür weiter.
Das Pruning passiert im Router und wirkt damit für alle Clients. Ein Plugin im Coding-Agenten, das dasselbe tut, hatte ich kurz drin und wieder entfernt. Zwei Stellen, die unabhängig voneinander kürzen, würden sich gegenseitig den Cache zerschießen.
Wohin der Kontext eigentlich geht
Bevor ich weiterbaue, habe ich nachgezählt. Ausgewertet wurden 292 Agenten-Sitzungen mit zusammen 62,5 Millionen Zeichen Verlauf:
| Anteil | Was |
|---|---|
| 41 % | Nachdenken und Text des Modells |
| 39 % | gelesene Dateien und andere Werkzeug-Ausgaben |
| 8 % | Dateien, die der Agent selbst zurückgeschrieben hat |
| 12 % | alles Übrige |
Das Pruning kümmert sich bisher nur um die 39 %. Das Nachdenken früherer Antworten schickt das Chat-Template bei jeder Anfrage vollständig wieder mit. Als Nächstes kürzt der Router auch altes Nachdenken und zurückgeschriebene Dateien, jeweils mit eigenem Schalter. Beim Nachdenken bin ich vorsichtig, weil es das Modell beeinflussen kann. Danach kommt ein Benchmark-Vergleich.
Die Abbrüche beim Zusammenfassen
Immer wieder brachen Agenten-Läufe mit dieser Meldung ab:
Compaction summary reached the output token limit
Die Ursache lag im Zusammenspiel von Agent und Router:
- Der Coding-Agent fasst den Verlauf standardmäßig erst zusammen, wenn nur noch 15 % des Fensters frei sind, also bei rund 109K von 128K.
- Die Anfrage dafür enthält den ganzen Verlauf plus bis zu 32K Ausgabe. Das passt nicht in 131.072 Token.
- Der Router kürzt deshalb die erlaubte Ausgabe, im Log zum Beispiel
32000 -> 4892. Das passierte 70-mal in 12 Stunden. - Inkling denkt immer mit. Bei unter 5.000 Token ist das Budget leer, bevor die Zusammenfassung fertig ist.
Mehr Ausgabe-Token im Agenten helfen nicht, der Router kürzt trotzdem. Die Lösung war, früher zusammenzufassen: Der Agent fasst jetzt bei 40 % Restfenster zusammen, also bei rund 77K. Dann bleibt genug Platz. Im ersten langen Lauf danach kam keine Kürzung der Ausgabe und keine zu große Anfrage mehr vor. Belegt ist das bisher an einem Lauf.
Qualität: Wie gut programmiert Inkling?
Gleicher schwerer Benchmark wie im Messlabor: ein Coding-Agent, Kontext 131K, Ausgabe 32K, 45 Minuten pro Lauf, versteckte Tests, die vorher gegen eine Referenzlösung geprüft wurden.
- E: Fehlersuche in Bestandscode, 6 Kundentickets als Symptom, eines davon ist kein Fehler. 25 versteckte Tests plus 19 Regressionstests.
- F: eine Tabellen-Engine von Grund auf, 210 versteckte Tests.
| Inkling 2 Mini | Flash-Next | Qwen3.8-27B | |
|---|---|---|---|
| Läufe | E 3, F 3 | E 6, F 6 | E 4, F 4 |
| E komplett grün | 3/3 | 6/6 | 4/4 |
| E Zeit, Median | 215 s | 166 s | 475 s |
| F versteckte Tests | 208 · 209 · 1 | 204 · 210 · 207 · 207 · 209 · 209 | 195 · 119 · 167 · 135 |
| F Median | 208/210 (99 %) | 99 % | 72 % |
| F im Zeitlimit fertig | 1 von 3 | 5 von 6 | 0 von 4 |
Die Inkling-Läufe stammen vom 21. November. Damals lief Inkling auf einer Instanz mit einem Platz und ohne DSpark, also nicht im heutigen Aufbau. Modell und Gewichte sind dieselben. Ein Lauf im neuen Aufbau steht noch aus.
- Über dem 27B, klar. Bei der Fehlersuche ist Inkling mehr als doppelt so schnell. In F liegt es 27 Prozentpunkte vorn, und es testet systematisch. Das 27B hat die Tests nie gestartet.
- Bei den fertigen Lösungen gleichauf mit Flash-Next. Der Median in F ist derselbe.
- Etwas unter Flash-Next bei der Abschlussdisziplin. Inkling baut nach grünen Tests weiter um und läuft dann ins Zeitlimit. Einmal blieb es mitten in einem Umbau hängen: Eine Funktion lieferte schon fünf Werte, der Aufrufer erwartete noch drei. Ergebnis 1 von 210.
Nachtrag: der Abschluss-Hinweis
Am Abend danach habe ich F noch dreimal laufen lassen, mit einem Zusatz im Auftrag: „Arbeite in kleinen Schritten und halte den Code jederzeit lauffähig. Sobald alle Tests grün sind und die Spec erfüllt ist, schließe ab und baue nichts mehr um.“
| Lauf | versteckte Tests | fertig |
|---|---|---|
| 1 | 207/210 | Zeitlimit |
| 2 | 209/210 | ja, 35 min |
| 3 | 201/210 | Zeitlimit |
Der Totalausfall kam damit nicht mehr vor, das schlechteste Ergebnis waren 201 von 210. Fertig wurde aber wieder nur 1 von 3. Über alle sechs F-Läufe liegt der Median bei 207,5 von 210 (99 %). Der Hinweis macht Inkling robuster, aber nicht disziplinierter.
RAM: das Nadelöhr ist weg
Das war für mich im Alltag die größte Änderung. Unter Strata war Swap der Normalzustand: 16 GB vor dem Umbau, und bei Langkontext-Tests wuchs er weiter, einmal um 4,7 GB in einem einzigen Testfenster.
Am 22. November habe ich zweimal alle sechs Plätze belegt und dabei mitgeschaut:
- Das Dashboard zeigte „ROUTER // belegt 6/6“.
- Auslagern und Einlagern (
vmstat, Spaltensi/so) blieben beide Male über die ganze Messung bei 0. - Belegt waren 26 bis 28 GB von 124 GB RAM, verfügbar rund 96 bis 99 GB.
Im Swap liegen noch 7,35 GB. Das sind alte Seiten aus der Strata-Zeit, die nicht mehr gebraucht und deshalb nicht zurückgeholt werden. Linux leert den Swap nicht von selbst, solange niemand die Seiten anfasst. „Nichts wird mehr ausgelagert“ stimmt also, „der Swap ist leer“ nicht.
Der Grund ist einfach: vLLM hält Gewichte und KV-Cache komplett im VRAM. Den RAM brauchen die Inkling-Instanzen nur für den Prozess selbst.
Momentaufnahme unter Last
Für die Screenshots habe ich sechs Code-Anfragen gleichzeitig über den Router geschickt, je 2.500 Token Ausgabe. Daneben lief normale Last von anderen Clients.
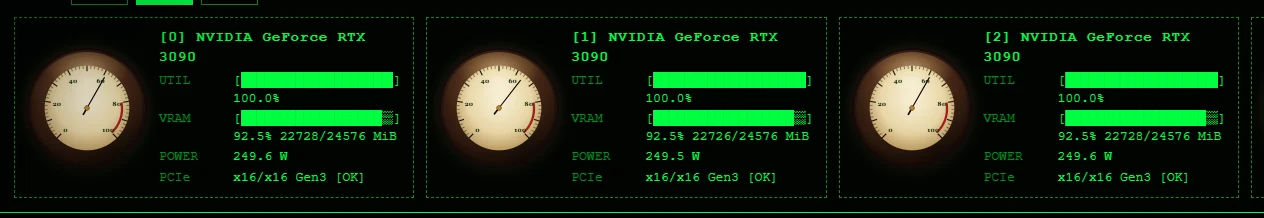
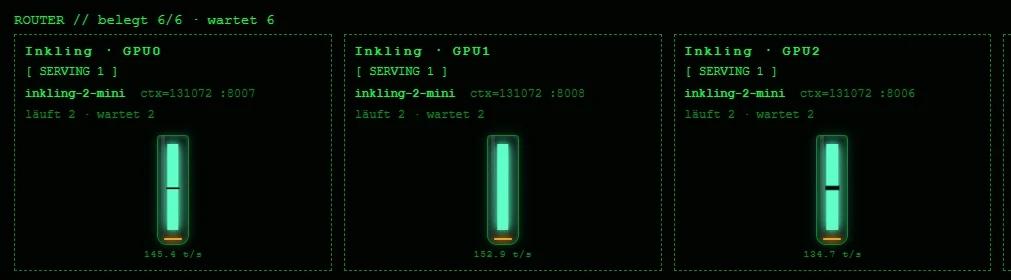
- Je Karte 2 laufend und 2 wartend, 145, 153 und 135 Token/s, zusammen rund 430 Token/s. Gemeint ist die erzeugte Ausgabe aller Plätze einer Karte zusammen.
- Bei einem zweiten Durchgang zeigte das Dashboard 169, 160 und 163 Token/s, zusammen rund 490 Token/s.
- Beide Male standen alle drei Karten auf 100 % Auslastung und rund 250 W.
Das ist eine Momentaufnahme mit fremder Last daneben, kein sauberer Benchmark. Einen Durchsatztest über alle drei Karten unter kontrollierten Bedingungen habe ich noch nicht gemacht.
Was nicht rosig ist
- Fließtext wird mit DSpark nicht schneller, unter Last eher langsamer.
- Kein Platz für zwei volle 128K-Gespräche auf einer Karte, seit DSpark Cache kostet.
- Abschlussdisziplin. Mit Zeitlimit ist Inkling riskanter als Flash-Next.
- Thinking läuft immer, und zwar auf Englisch. Abschalten lässt es sich nicht, das Modell ignoriert den Schalter. Das kostet Ausgabe-Budget und war ein Teil des Problems beim Zusammenfassen.
- Allein-Tempo: Mit Flash-Next auf zwei Karten habe ich bei Code zeitweise rund 200 t/s gesehen. Das war eine Beobachtung, keine Messreihe. Pro Anfrage ist Inkling also nicht in jedem Fall das schnellste Modell, das Zuse je hatte. Pro Platz unter Parallel-Last ist es das sehr wohl.
- Die Bindung an die Karte kennt keine Last. Beim Screenshot-Test ist mir das selbst passiert. Ich habe dieselben sechs Prompts noch einmal geschickt. Der Router erkennt ein Gespräch an seinen Nachrichten bis zur ersten Nutzerfrage, hielt die Wiederholung also für Folgeturns und schickte sie auf ihre alte Karte. GPU0 und GPU1 hatten je 4 Anfragen, GPU2 war leer, und eine Anfrage brauchte 122 statt rund 30 Sekunden. Im Alltag sind Gespräche verschieden, aber ein langer Agent bleibt auch dann an seiner Karte, wenn sie voll ist. Ein Ausweichen bei Überlast steht als Nächstes auf der Liste.
Was ich daraus mitnehme
- Breite schlägt Größe, wenn mehrere Agenten gleichzeitig arbeiten. Drei unabhängige Karten mit einem Modell, das auf eine passt, sind robuster als ein größeres Modell, das sich zwei Karten teilen muss.
- Der Router ist die eigentliche Infrastruktur. Verteilen, Gespräche auf ihrer Karte halten, Kontext kürzen, Grenzen durchsetzen: Das gehört an eine Stelle, nicht in jeden Client.
- Prefix-Cache ist ein Designkriterium. Jede Kürzung, die den Anfang eines Verlaufs ändert, kostet beim nächsten Mal das komplette Neueinlesen. Darum springt die Grenze nur in Stufen.
- Messen, bevor man optimiert. Dass 41 % des Kontexts Nachdenken ist, hätte ich nicht geschätzt.
- „Kein Kernel für deine Karte“ ist ein Arbeitsauftrag, kein Urteil. Zwei Bausteine in PyTorch und Triton, und das spekulative Dekodieren lief.
Wie gemessen
Tempo pro Karte: Einzelanfragen mit 700 Ausgabe-Token, Thinking aus, Power-Limit 250 W, einmal allein auf der Karte
und einmal im laufenden Betrieb. Router-Werte: Header und Log des Routers, Prefix-Cache-Treffer an der Zeit einer
wiederholten Anfrage. Kontextanteile: Zeichen der gespeicherten Verläufe aus 292 Agenten-Sitzungen, nach Art der
Nachricht. Coding-Benchmark: eigene Aufgaben, 45 Minuten Limit pro Lauf, Auswertung nur über versteckte Tests. RAM:
free und vmstat auf dem Server, während das Dashboard 6 von 6 belegte Plätze zeigte.